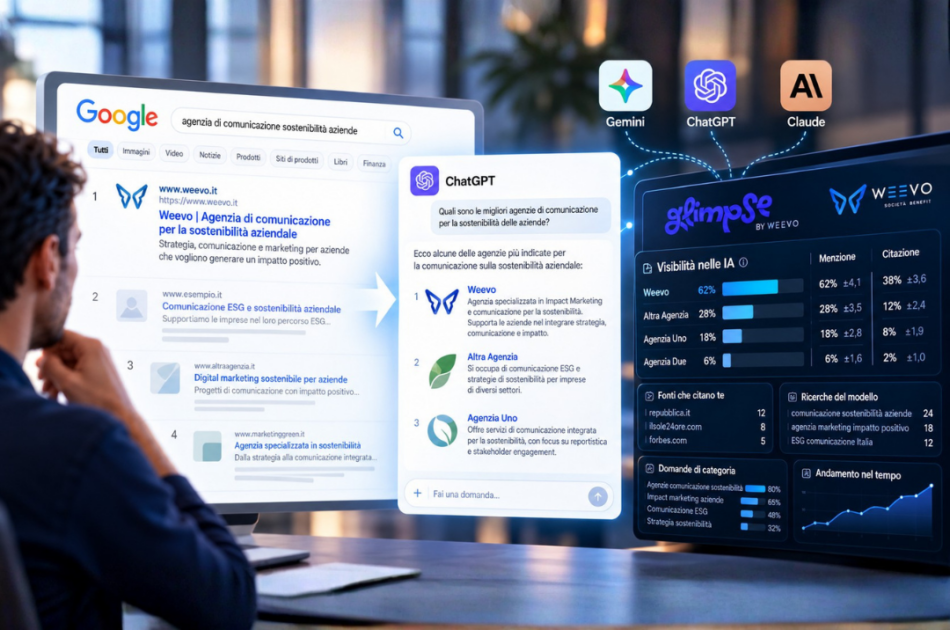
Fino a poco tempo fa, chi cercava un fornitore riceveva dieci collegamenti e sceglieva da solo. Oggi, per molte domande, riceve un paragrafo già scritto con tre o quattro nomi dentro. Chi non compare in quel paragrafo non perde il confronto con gli altri: semplicemente non viene considerato. Nella ricerca tradizionale c’era una seconda pagina, qui no.
La domanda che si fanno le aziende è quindi cambiata. Prima era «come arrivo primo su Google». Adesso è «come finisco dentro la risposta». E ce n’è una seconda, che si fa molto meno: «come faccio a sapere se ci sono davvero».
Chi entra nella risposta, e perché
Un modello linguistico non ha una classifica da scalare. Quando risponde, mette insieme quello che ha imparato durante l’addestramento e, sempre più spesso, quello che trova cercando sul web in quel momento. I nomi che finiscono nel paragrafo sono quelli che il modello incontra spesso, in contesti coerenti e in fonti che considera affidabili. Da qui vengono alcune indicazioni pratiche.
Conta chi parla di te, non solo cosa dici tu. Un marchio citato solo dal proprio sito è in una posizione fragile. Quando il modello cerca una fonte per sostenere una raccomandazione, tende ad andare su pagine di terzi: riviste di settore, confronti, elenchi, forum, schede di associazioni. Se tu non ci sei, lui nominerà chi c’è.
Conta la coerenza. Un’azienda che si descrive in un modo sul sito, in un altro su LinkedIn e in un terzo nelle schede dei distributori manda al modello tre segnali deboli invece di uno forte. Lo stesso vale per il nome: «Weevo», «Weevo Srl» e «Weevo Società Benefit» per un lettore sono la stessa azienda, per un sistema che conta le occorrenze possono essere tre.
Conta la domanda, più della parola chiave. Le persone non chiedono all’IA «agenzia web Modena». Scrivono «la mia azienda non riesce a farsi trovare online, a chi mi rivolgo?». Un marchio può comparire in tutte le risposte alle domande di categoria ed essere assente da quelle che partono da un problema, che spesso sono quelle in cui si decide.
Contano le parole che il modello digita. Quando cerca sul web, un modello non usa la tua domanda così com’è. La trasforma in una o più ricerche sue. Se la stessa ricerca ricorre in quasi tutte le risposte, è la porta da cui il modello entra nel tema, e una pagina scritta per quelle parole ha molte più probabilità di essere letta.
Non conta la quantità di ottimizzazione. Riempire le pagine di parole chiave serve poco. Servono contenuti coerenti, distribuiti su più fonti e autorevoli: pagine che rispondono davvero a una domanda, scritte da chi ne sa qualcosa, e riprese da altri.
Il problema di chiedere a ChatGPT «mi conosci?»
Per sapere se ci sono, la tentazione è aprire un assistente e fare una domanda. Il guaio è che una risposta sola non dice quasi niente. I modelli non sono deterministici: la stessa domanda, posta cento volte, dà cento risposte diverse. In alcune il tuo marchio c’è, in altre no. Quello che serve sapere è in quante.
E cambia molto da un modello all’altro. Ecco un caso reale, dieci risposte per modello alla stessa domanda sul mercato dei mollifici:
| Marchio | Gemini | ChatGPT |
|---|---|---|
| Mollificio Adige | 100% | mai |
| Gardamolle | 100% | 100% |
| MKF Mollificio | 40% | 100% |
| Alpimol | mai | 100% |
«Mai» non è «0%»: vuol dire che quel modello quel marchio non l’ha proprio nominato. Guardando un solo assistente, nessuna di queste righe si vede.
C’è poi una seconda trappola: una percentuale senza il suo margine d’errore non dice quanto ci si possa contare. Un 30% misurato su 20 risposte e un 30% misurato su 1.000 sono due informazioni molto diverse.
GLIMPSE: la stessa domanda, centinaia di volte
GLIMPSE by Weevo è lo strumento pià all’avanguardia in Italia per rispondere a questa seconda domanda. Pone la stessa domanda decine o centinaia di volte a Gemini, a ChatGPT e a Claude, conta in quante risposte compare ciascun marchio e dichiara quanto è largo l’intervallo attorno a quel numero. Non è un sondaggio: misura il comportamento dei modelli.
Ecco le funzionalità principali.
Claude, il terzo assistente
Accanto a Gemini e ChatGPT ora c’è Claude di Anthropic, con la ricerca sul web. Tre modelli sulla stessa domanda mostrano quanto poco si somiglino: un marchio può essere sempre presente in uno e mai negli altri due.
Si parte dal sito, con una procedura guidata
Scrivi l’indirizzo del tuo sito. GLIMPSE by Weevo legge la pagina, capisce di cosa ti occupi e propone le domande che un cliente porrebbe a un’IA nel tuo mercato, divise in cinque tipi: categoria, problema, confronto, raccomandazione e marca. Se al tuo elenco manca un tipo, GLIMPSE by Weevo te lo segnala.
Poi scegli una domanda e parte l’assaggio: dieci risposte da Gemini e dieci da ChatGPT, affiancate, in meno di un minuto. I primi tre assaggi sono gratuiti, senza carta di credito.
Il margine prima di spendere
Prima di lanciare una ricerca vera, accanto a ogni profondità (da 20 a 2.500 risposte) GLIMPSE by Weevo mostra il margine che otterrai. E non solo in punti, ma in proporzione alla tua quota. Con 200 risposte, ±2,1 punti su una quota del 2% sembrano pochi, ma sono ±107% del valore: l’intervallo è più largo del numero stesso. In un mercato affollato la tua quota è piccola per forza, e con la stessa profondità ottieni molta meno precisione. È meglio saperlo prima di pagare, non dopo.
Menzione e citazione, separate
«Visibilità nelle IA» non è una cosa sola. GLIMPSE by Weevo ne misura due, sullo stesso denominatore:
- la quota di menzione: in quante risposte il tuo marchio viene nominato;
- la quota di citazione: in quante risposte uno dei tuoi domini compare fra le fonti consultate dal modello.
Un marchio al 90% di menzione e allo 0% di citazione ha un problema preciso: il modello lo nomina, ma quando cerca una fonte va da qualcun altro. La quota di citazione si legge domanda per domanda, e per ogni canale che dichiari: il sito principale, un microsito, una scheda su uno store.
Il Brand center: dal numero a cosa fare
Un numero da solo non dice cosa fare. Il Brand center mette insieme quello che sanno le risposte e quello che sa il tuo sito:
- Chi ti cita, e chi cita i tuoi concorrenti. Per ogni domanda, le fonti che sostengono te e quelle che sostengono gli altri. Se un passaggio nomina tre marchi, GLIMPSE by Weevo non tira a indovinare a chi appartenga.
- Le pagine dove non ci sei. I siti di terzi che il modello usa per sostenere altri marchi e mai te. È un elenco di posti su cui lavorare, e i siti dei concorrenti ne restano fuori.
- Le parole che il modello digita. Con Gemini e Claude, le ricerche che il modello ha davvero scritto prima di rispondere, contate. Con ChatGPT questo dato non esiste, e GLIMPSE by Weevo non lo inventa.
- Le domande dove non compari. GLIMPSE by Weevo ti propone di misurare anche le domande in cui il tuo marchio oggi non compare, perché è lì che c’è margine.
- Il traffico che ne arriva. Collegando Google Analytics, accanto alla quota di menzione vedi quante visite sono arrivate da ciascun assistente e se chi è arrivato è rimasto sul sito.
Nel tempo, con un registro del metodo
Le ricerche si ripetono da sole ogni settimana, mese, trimestre o semestre. Se fra due misure cambia la domanda, il modello, il paese o l’uso della ricerca sul web, GLIMPSE by Weevo segnala che la serie non è più confrontabile e mostra dove è cambiata. Molti «crolli» nei dati di visibilità sono in realtà cambi di strumento, e vanno distinti da un vero cambiamento del mercato.
I nomi, corretti da chi conosce il mercato
I modelli scrivono lo stesso nome in modi diversi. GLIMPSE by Weevo unisce le grafie che indicano lo stesso soggetto e ti mostra quali unioni ha fatto, perché alcune saranno sbagliate: «Armani» e «Armani Exchange» non sono la stessa cosa. Le correzioni le fai tu e si riapplicano anche alle ricerche già fatte, senza rifarle e senza spendere crediti.
Confronti e report da consegnare
Più ricerche si possono mettere a confronto, e ora il confronto si salva come report e si esporta in CSV. I report si condividono con un collegamento, anche con chi non ha un account, in otto lingue, insieme alle grafiche pronte per i social. Dentro c’è Phil, che legge il report e lo commenta nella tua lingua: ti dice dove la distanza fra due marchi è dentro il margine d’errore, e quindi non è una vera distanza, e da dove conviene cominciare.
Webinar gratuito l’8 ottobre
Misurare è la seconda metà del lavoro. La prima è capire perché certe marche entrano nella risposta e altre no, e cosa si può fare per esserci.
Weevo organizza «Dentro la risposta: come le marche entrano nelle risposte delle IA», un webinar gratuito giovedì 8 ottobre 2026 alle 14:30, online, della durata di circa un’ora.
Cosa sarà mostrato:
- dalla lista alla sintesi: cosa cambia per una marca quando chi cerca non sceglie più fra dieci collegamenti, ma legge una risposta sola;
- chi entra nella risposta: perché contano contenuti coerenti, distribuiti e autorevoli più della quantità di ottimizzazione;
- un caso di studio B2B: un’azienda reale, e come GLIMPSE by Weevo misura la presenza delle marche nelle risposte delle IA.
Conduce Gabriele Carboni, autore, consulente e formatore, coautore con Philip Kotler di Management Illuminato e professore onorario di marketing alla Georgian American University.
. L’iscrizione è gratuita e aperta a tutti.
Nel frattempo puoi fare una domanda del tuo mercato e guardare chi risponde al posto tuo: , tre assaggi senza carta di credito.